La evolución de la inteligencia artificial está cambiando la forma en que se diseñan los sistemas electrónicos. El aumento de la capacidad de cálculo de los procesadores ha permitido desarrollar modelos cada vez más complejos, pero también ha puesto de manifiesto una limitación fundamental: los datos deben llegar al procesador con suficiente rapidez para aprovechar su capacidad de cálculo.
Durante el entrenamiento y la inferencia de modelos de IA, las GPU y los aceleradores necesitan acceder continuamente a pesos, activaciones y otros datos intermedios. Si la memoria no puede suministrar esa información con suficiente ancho de banda, una parte de la capacidad de procesamiento puede quedar sin utilizar.
Para responder a este problema, las arquitecturas actuales combinan diferentes tecnologías de memoria e interconexión. Entre ellas destacan HBM (High Bandwidth Memory), diseñada para proporcionar un ancho de banda muy elevado cerca de los aceleradores, y CXL (Compute Express Link), que permite conectar y gestionar recursos de computación y memoria de forma más flexible.
Aunque ambas tecnologías están especialmente asociadas a servidores y centros de datos, su evolución también ofrece conclusiones relevantes para el diseño de sistemas embebidos y dispositivos Edge AI.
En este artículo analizamos cómo funcionan HBM y CXL, qué diferencias existen entre ellas y qué implicaciones tienen para la arquitectura hardware y el diseño electrónico.
La elección de memoria depende de las necesidades concretas de cada producto: capacidad, consumo, velocidad de acceso y recursos disponibles en el procesador. Estos criterios son fundamentales tanto en dispositivos IoT convencionales como en sistemas más exigentes que incorporan procesamiento local. En nuestro artículo sobre cómo elegir la arquitectura de memoria de un dispositivo IoT analizamos las principales tecnologías disponibles y los factores que conviene valorar antes de seleccionar la memoria para un diseño electrónico.
Del problema de memoria en un dispositivo IoT al problema de memoria en la IA
En un dispositivo IoT convencional, la selección de memoria suele comenzar por determinar cuánta Flash necesita el firmware y cuánta SRAM requiere la aplicación durante su funcionamiento. También deben considerarse los buffers de comunicaciones, los datos de los sensores y, en algunos casos, el almacenamiento de modelos de inteligencia artificial o de actualizaciones OTA.
En sistemas más exigentes, como los equipos de visión artificial o los dispositivos Edge AI, la capacidad disponible deja de ser el único criterio. El sistema puede necesitar procesar imágenes, señales o modelos de IA que generan un flujo continuo de datos.
En estos casos, hay que responder a dos preguntas diferentes:
- ¿Cuánta memoria necesita el sistema? Determina la capacidad necesaria para almacenar los datos y mantenerlos disponibles durante la ejecución.
- ¿Con qué rapidez debe acceder a ellos? Determina el ancho de banda y la latencia que necesita la arquitectura para alimentar al procesador.
Ambos factores están relacionados, pero no son equivalentes. Una memoria puede tener una gran capacidad y, aun así, no proporcionar el ancho de banda necesario para una aplicación concreta.
Cuando la capacidad de cálculo supera a la velocidad de acceso a los datos
Una GPU puede ejecutar una enorme cantidad de operaciones por segundo. Sin embargo, necesita recibir continuamente los datos sobre los que debe trabajar.
Si el procesador termina de utilizar los datos disponibles antes de que lleguen los siguientes, debe esperar o reducir su actividad. Esta situación se conoce como cuello de botella de memoria.
El problema resulta especialmente relevante en las cargas de trabajo de IA que realizan operaciones sobre grandes matrices y necesitan transferir continuamente pesos, activaciones y resultados intermedios.
El rendimiento real depende, por tanto, de la combinación de varios factores: capacidad de cálculo, ancho de banda, latencia, capacidad de memoria y eficiencia del movimiento de datos. Aumentar únicamente la potencia del procesador no garantiza una mejora proporcional si la memoria se convierte en el factor limitante.
Esta necesidad de mantener alimentados a los aceleradores explica el desarrollo de tecnologías como HBM.
¿Qué es HBM?
HBM significa High Bandwidth Memory, o memoria de alto ancho de banda. Es una tecnología de memoria DRAM definida mediante estándares de JEDEC y diseñada para proporcionar una elevada velocidad de transferencia de datos en sistemas de alto rendimiento.
Se utiliza principalmente en GPU, aceleradores de inteligencia artificial y sistemas de computación de alto rendimiento, donde el ancho de banda de memoria puede condicionar directamente el rendimiento de la aplicación.
A diferencia de una arquitectura convencional que conecta chips de memoria a través de una interfaz relativamente más estrecha, HBM emplea una interfaz muy amplia y numerosas conexiones en paralelo. Además, integra varios chips de memoria apilados verticalmente, lo que permite aumentar la densidad de interconexión.
Cómo funciona la memoria HBM
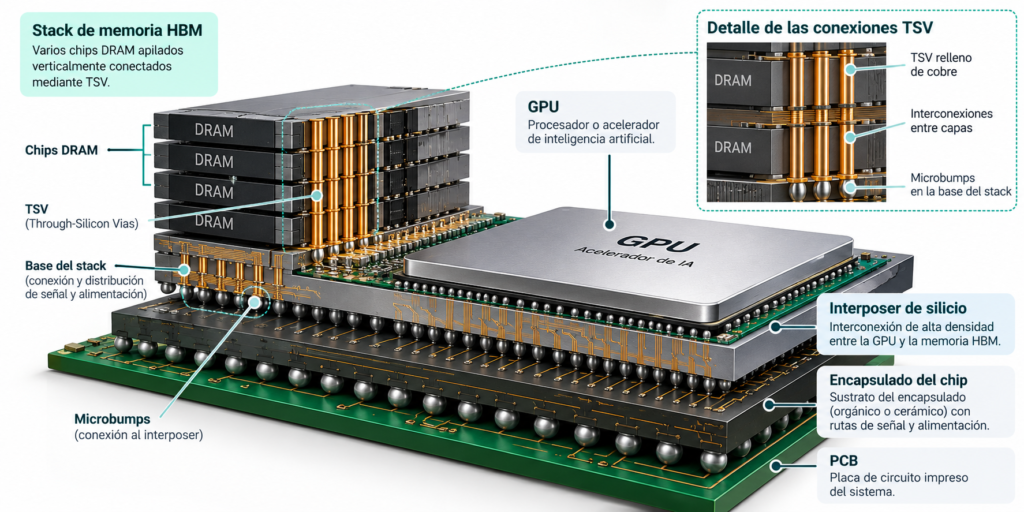
Una de las características más importantes de HBM es su arquitectura física. Varios chips DRAM se apilan para formar un conjunto de memoria, denominado stack. Las diferentes capas se conectan mediante TSV (Through-Silicon Vias), vías conductoras que atraviesan el silicio y permiten establecer conexiones verticales.
El conjunto se integra cerca del procesador o acelerador mediante tecnologías de encapsulado avanzado. Dependiendo de la implementación, pueden utilizarse interposers de silicio u otras soluciones de integración de alta densidad.
Este enfoque permite establecer una interfaz de memoria extremadamente amplia y situar la memoria muy cerca del componente que la utiliza. La arquitectura reduce la necesidad de depender exclusivamente de aumentar la velocidad de cada conexión individual para incrementar el ancho de banda total.
Para conseguir estas altas densidades de interconexión, HBM necesita tecnologías de encapsulado que permitan integrar varios chips de memoria junto al procesador y conectarlos mediante numerosas conexiones de alta velocidad. En este ámbito, las tecnologías de encapsulado avanzado 2.5D y 3D de TSMC muestran cómo es posible combinar diferentes componentes semiconductores en estructuras más compactas, optimizando su integración y las comunicaciones entre chips.
¿Por qué HBM proporciona tanto ancho de banda?
La principal ventaja de HBM no consiste simplemente en utilizar una memoria que funciona a una frecuencia elevada. Su ancho de banda procede de combinar una interfaz muy amplia con transferencias paralelas y una integración física especialmente diseñada para conectar memoria y procesador.
El ancho de banda teórico depende del número de bits transferidos en cada operación y de la velocidad efectiva de transferencia de la interfaz. Por eso, una interfaz muy amplia puede proporcionar un gran caudal de datos sin depender exclusivamente de incrementar la frecuencia.
La proximidad física también ayuda a construir una interconexión de alta densidad. No obstante, HBM requiere encapsulado avanzado, un diseño de alimentación y señalización cuidadoso y una cadena de fabricación más compleja que la de muchas soluciones de memoria convencionales.
Por tanto, HBM ofrece ventajas importantes en ancho de banda, pero no es una solución universal. Su coste, capacidad disponible, complejidad de integración y requisitos del sistema deben valorarse frente a las necesidades reales de la aplicación.
¿Por qué HBM es importante para la inteligencia artificial?
Los modelos de IA pueden realizar operaciones matemáticas a gran velocidad, pero necesitan acceder a los datos que alimentan esas operaciones.
En entrenamiento, el sistema debe manejar pesos, activaciones, gradientes y otros datos intermedios. En inferencia, las necesidades dependen de la arquitectura del modelo, el tamaño de los lotes, la longitud de las secuencias y la estrategia de ejecución.
En determinadas cargas de trabajo, la capacidad de cálculo puede ser suficiente, pero el ancho de banda de memoria limita la velocidad efectiva. HBM ayuda a reducir este problema al proporcionar un elevado caudal de datos entre la memoria y el acelerador.
Esto no significa que HBM elimine todos los cuellos de botella. La caché, la capacidad disponible, el acceso a almacenamiento, la interconexión entre aceleradores y la eficiencia del software también pueden limitar el rendimiento.
HBM frente a DDR: dos tecnologías con objetivos diferentes
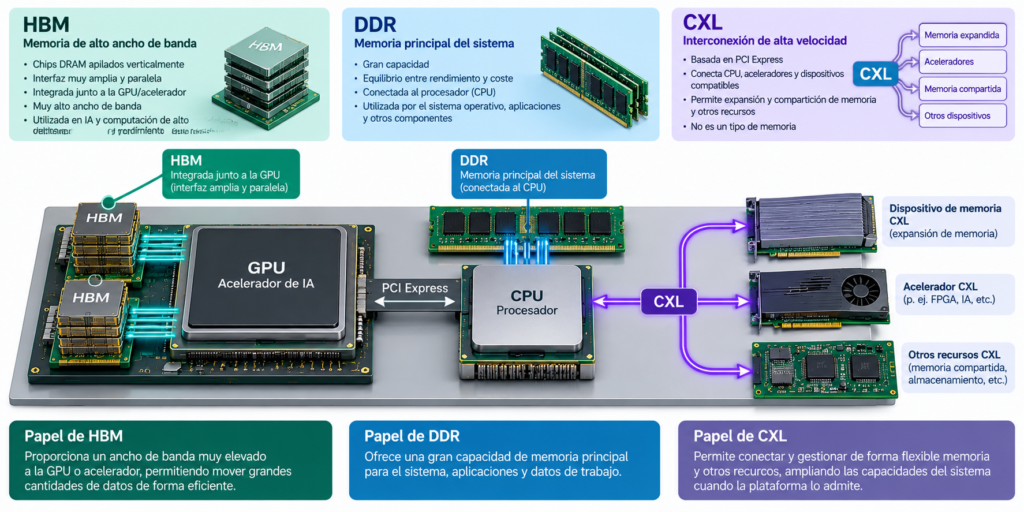
HBM no debe entenderse como un sustituto universal de DDR. Ambas tecnologías responden a requisitos distintos y pueden coexistir en un mismo sistema.
DDR es una familia de tecnologías de memoria utilizada ampliamente como memoria principal en ordenadores, servidores y otros sistemas. Ofrece un equilibrio entre capacidad, coste, rendimiento y facilidad de integración.
HBM prioriza el ancho de banda mediante una interfaz amplia y un encapsulado avanzado, lo que la hace especialmente adecuada para aceleradores que necesitan mover grandes cantidades de datos.
| Característica | DDR | HBM |
|---|---|---|
| Función habitual | Memoria principal del sistema | Memoria de alto ancho de banda para aceleradores |
| Interfaz | Comparativamente más estrecha | Muy amplia y paralela |
| Integración | Chips o módulos conectados al sistema | Stack integrado mediante encapsulado avanzado |
| Capacidad | Flexible según módulos y plataforma | Condicionada por el stack y la implementación |
| Ancho de banda | Depende de la generación, canales y configuración | Muy elevado por la amplitud de la interfaz |
| Coste y complejidad | Amplia variedad de soluciones | Mayor complejidad de integración |
| Aplicaciones habituales | Ordenadores, servidores y sistemas embebidos | GPU, aceleradores de IA y computación de alto rendimiento |
No existe una tecnología que sea mejor en todos los escenarios. La elección depende de las necesidades de capacidad, ancho de banda, consumo, coste y arquitectura del producto.
¿Qué es CXL y qué aporta a la arquitectura de memoria?
CXL significa Compute Express Link. Es un estándar de interconexión de alta velocidad basado en la capa física de PCI Express, con protocolos adicionales para comunicar procesadores, aceleradores y dispositivos compatibles.
Las especificaciones son mantenidas por el CXL Consortium.
A diferencia de HBM, CXL no es un tipo de memoria. Es una tecnología de interconexión que permite construir arquitecturas en las que los recursos de computación y memoria pueden organizarse de forma más flexible.
En los sistemas tradicionales, la memoria principal suele estar conectada directamente al procesador. Esta organización funciona bien en muchos escenarios, pero puede limitar las posibilidades de ampliación o hacer que la capacidad de memoria disponible no se adapte bien a las necesidades de cada carga de trabajo.
CXL permite explorar otras configuraciones, como la expansión de memoria mediante dispositivos compatibles y, cuando la plataforma lo admite, arquitecturas de compartición o agrupación de recursos.
Ampliar la memoria disponible
Una aplicación puede necesitar más capacidad de memoria de la que resulta conveniente instalar directamente junto al procesador. En determinados sistemas, un dispositivo de expansión de memoria compatible con CXL permite incorporar recursos adicionales sin tener que rediseñar toda la arquitectura en torno a una configuración de memoria local diferente.
Esto puede resultar útil en servidores que ejecutan aplicaciones con requisitos de memoria elevados, bases de datos en memoria o cargas de trabajo de IA que necesitan mantener grandes conjuntos de datos disponibles.
Sin embargo, la memoria conectada mediante CXL no debe considerarse idéntica a la memoria local. Sus prestaciones dependen de la topología, el dispositivo, el controlador, la plataforma y la configuración. La latencia y el ancho de banda pueden diferir de los de la memoria directamente conectada al procesador.
Por eso, el uso de memoria expandida debe diseñarse teniendo en cuenta qué datos necesitan acceso rápido y cuáles pueden tolerar las características de ese nivel adicional.
Compartir y organizar recursos de memoria
Además de ampliar la capacidad, determinadas arquitecturas CXL permiten configurar recursos de memoria para que puedan asignarse o compartirse entre diferentes hosts compatibles.
Esto abre posibilidades para mejorar el aprovechamiento de los recursos en centros de datos. Por ejemplo, la capacidad de memoria puede distribuirse de acuerdo con las necesidades de las aplicaciones, siempre dentro de las capacidades que ofrezcan los dispositivos y la infraestructura.
No obstante, CXL no garantiza automáticamente que toda la memoria pueda compartirse libremente entre cualquier procesador. Las funciones disponibles dependen de la versión del estándar, los dispositivos, el firmware y la topología del sistema. También deben resolverse aspectos de seguridad, coherencia, asignación de recursos y gestión del sistema operativo.
HBM y CXL pueden formar parte de la misma arquitectura
HBM y CXL abordan problemas diferentes, por lo que no tienen por qué competir entre sí.
HBM proporciona un ancho de banda muy elevado junto al acelerador. CXL permite conectar recursos adicionales y construir arquitecturas de memoria más flexibles, cuando la plataforma y los dispositivos admiten esa configuración.
Un sistema de IA puede combinar HBM para los datos que requieren un ancho de banda elevado, DDR como memoria principal y recursos adicionales conectados mediante CXL para determinadas necesidades de capacidad.
Esta organización no es idéntica en todos los servidores ni está disponible en cualquier configuración. La arquitectura concreta depende del procesador, el acelerador, el sistema de memoria y los requisitos de la aplicación.
La nueva jerarquía de memoria para sistemas de IA
Los sistemas de computación modernos no dependen de un único tipo de memoria. Combinan diferentes niveles porque cada tecnología ofrece un equilibrio distinto entre latencia, ancho de banda, capacidad, persistencia y coste.
La organización exacta depende de la arquitectura, pero puede entenderse mediante varios niveles funcionales.
Caché y memorias cercanas al procesamiento
Las cachés del procesador almacenan datos e instrucciones que pueden reutilizarse, reduciendo la necesidad de acceder continuamente a niveles de memoria más alejados. Su capacidad es limitada, pero su latencia es baja.
En sistemas embebidos, la SRAM suele utilizarse para variables, buffers y datos que requieren un acceso rápido. En aceleradores de IA, las memorias internas y las cachés pueden ayudar a reutilizar datos y reducir las transferencias hacia la memoria externa.
HBM ocupa otra posición: proporciona una capacidad y un ancho de banda elevados para alimentar aceleradores, aunque sus características de latencia no deben confundirse con las de una caché integrada en el procesador.
DDR como memoria principal
DDR permite disponer de una capacidad de memoria principal considerable. Se utiliza para mantener datos de trabajo, procesos y conjuntos de información que no necesitan permanecer en la memoria más cercana al procesador.
Su relación entre capacidad, coste y rendimiento la convierte en una tecnología fundamental para ordenadores y servidores. También puede formar parte de sistemas embebidos de mayores prestaciones.
Memoria expandida mediante CXL
En las plataformas compatibles, CXL permite añadir recursos de memoria y configurar arquitecturas con niveles adicionales. Estos recursos pueden ayudar a aumentar la capacidad disponible, aunque su rendimiento depende de la interconexión y no equivale necesariamente al de la memoria local.
Su utilidad debe evaluarse según el patrón de acceso de la aplicación. Si un proceso necesita un ancho de banda muy elevado y acceso frecuente a determinados datos, mantenerlos en memoria local puede ser más adecuado que acceder continuamente a un recurso remoto.
Almacenamiento persistente
SSD y NVMe se utilizan para conservar modelos, conjuntos de datos, firmware y otros archivos. Ofrecen una capacidad elevada y mantienen los datos sin alimentación, pero no sustituyen a la memoria de trabajo que necesita el procesador durante una ejecución.
En una aplicación de IA, el almacenamiento puede contener el modelo completo, mientras que los datos necesarios para ejecutar una operación se cargan en los niveles de memoria adecuados.
| Tecnología o nivel | Función principal | Criterio destacado |
|---|---|---|
| Caché y SRAM | Mantener datos de acceso frecuente o rápido | Latencia y proximidad |
| HBM | Alimentar aceleradores de alto rendimiento | Ancho de banda |
| DDR | Proporcionar memoria principal | Capacidad y equilibrio entre coste y rendimiento |
| Memoria conectada mediante CXL | Ampliar o reorganizar recursos compatibles | Capacidad y flexibilidad |
| SSD / NVMe | Almacenar datos de forma persistente | Capacidad y conservación de datos |
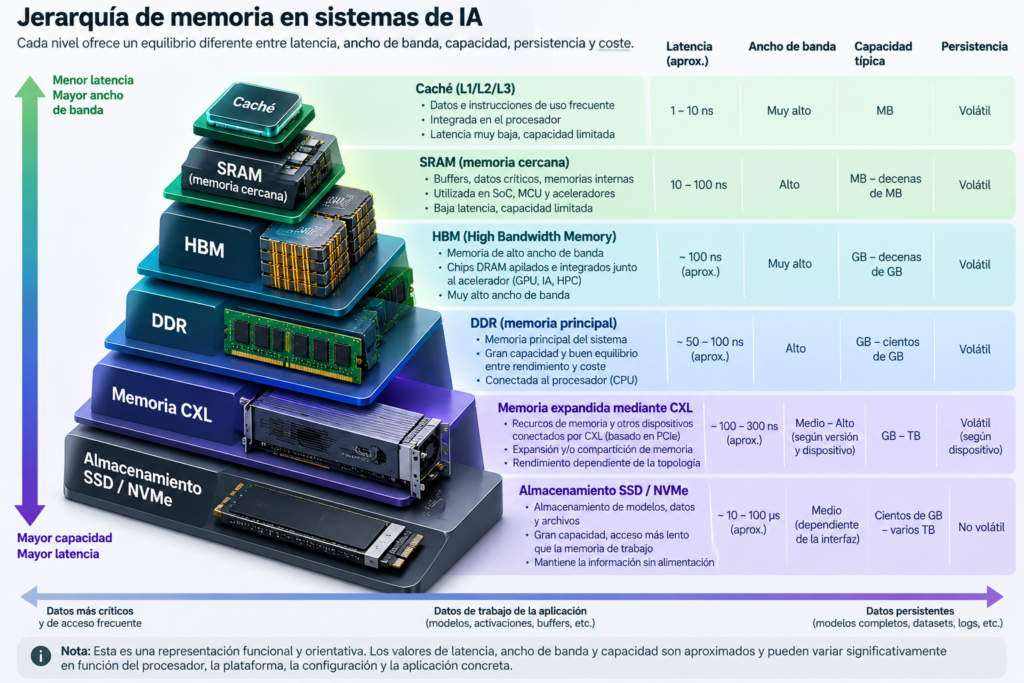
El objetivo de esta organización es colocar cada dato en el nivel que mejor se adapte a sus necesidades. Para conseguirlo, hay que considerar cómo se accede a la información, cuánto tiempo debe mantenerse disponible y qué prestaciones necesita la aplicación.
¿Qué implicaciones tiene esta evolución para Edge AI?
HBM y CXL están asociadas principalmente a servidores y sistemas de alto rendimiento. No tendría sentido trasladar automáticamente estas tecnologías a un dispositivo IoT convencional, donde el coste, el consumo y el tamaño suelen ser restricciones mucho más importantes.
Sin embargo, los principios que impulsan su desarrollo también son relevantes para los sistemas Edge AI: la memoria debe dimensionarse de acuerdo con la aplicación y el movimiento de datos forma parte del rendimiento global.
Aunque las tecnologías de memoria utilizadas en centros de datos y dispositivos embebidos son diferentes, ambas responden a un mismo reto: conseguir que el procesador disponga de los datos que necesita con suficiente rapidez y un consumo adecuado. Esta cuestión cobra especial importancia a medida que la inteligencia artificial se ejecuta directamente en los dispositivos. En nuestro artículo sobre cómo Edge AI está cambiando el diseño del hardware embebido profundizamos en cómo esta evolución está transformando la arquitectura de los productos electrónicos.
De un dispositivo IoT a un sistema Edge AI
En un dispositivo IoT sencillo, Flash y SRAM pueden ser suficientes para almacenar el firmware y ejecutar la aplicación. Cuando el producto incorpora visión artificial, audio o modelos de IA, los requisitos cambian.
El sistema puede necesitar almacenar el modelo, gestionar buffers de imagen, mantener datos intermedios y transferir información entre sensores, memoria y aceleradores. Según la plataforma, pueden utilizarse SRAM, PSRAM, SDRAM o DDR.
La elección no depende exclusivamente de la capacidad. También deben analizarse el ancho de banda, la latencia, el consumo, las interfaces disponibles y la compatibilidad con el procesador.
La elección de memoria debe realizarse en conjunto con el procesador y la plataforma de hardware, ya que cada solución ofrece diferentes prestaciones en capacidad de cálculo, consumo, interfaces y compatibilidad con memorias externas. Para valorar estas diferencias en un proyecto de inteligencia artificial embebida, puedes consultar nuestra comparativa de plataformas hardware para Edge AI, donde analizamos las opciones disponibles y los criterios que conviene considerar antes de seleccionar los componentes.
Más capacidad no siempre significa más rendimiento
Una memoria de mayor capacidad puede permitir almacenar un modelo más grande, pero no garantiza que el sistema pueda ejecutarlo a la velocidad requerida.
Si la aplicación necesita acceder continuamente a grandes cantidades de datos, el ancho de banda puede ser más importante que la capacidad adicional. En otros casos, el cuello de botella puede estar en la potencia de cálculo, la transferencia desde los sensores, el software o el almacenamiento.
Por eso, conviene medir las necesidades reales de la aplicación antes de elegir los componentes. En visión artificial, por ejemplo, deben considerarse la resolución de imagen, la frecuencia de captura, el tamaño de los buffers y las operaciones que ejecutará el modelo.
El encapsulado y la PCB forman parte de la solución
La evolución de HBM demuestra que el rendimiento no depende únicamente de los chips seleccionados. También importa cómo se integran y conectan.
En sistemas con interfaces de memoria de alta velocidad, la integridad de señal, la alimentación, la distribución de pistas, las longitudes, la impedancia y las restricciones del encapsulado pueden condicionar el diseño. En el caso de HBM, muchas de estas decisiones están ligadas al encapsulado avanzado y no se resuelven únicamente mediante el diseño de una PCB convencional.
En un dispositivo Edge AI, los requisitos serán diferentes, pero la conclusión es similar: la selección de memoria debe coordinarse con la elección del procesador y con las restricciones de diseño desde las primeras fases del proyecto.
Qué debe tener en cuenta un diseñador electrónico
La evolución de las arquitecturas de memoria para IA deja varias lecciones prácticas para el desarrollo de productos electrónicos.
1. Definir las necesidades reales de la aplicación
Antes de seleccionar una memoria, conviene identificar qué datos debe almacenar el sistema, cuánto tiempo deben permanecer disponibles y cómo se utilizarán durante la ejecución.
No requiere la misma arquitectura un dispositivo que lee unos pocos sensores periódicamente que una cámara que procesa imágenes en tiempo real.
2. Evaluar capacidad, ancho de banda y latencia
Estos tres factores deben analizarse conjuntamente. La capacidad determina cuántos datos pueden mantenerse disponibles; el ancho de banda, cuántos pueden transferirse por unidad de tiempo; y la latencia, cuánto tarda en completarse un acceso.
Una aplicación puede estar limitada por uno de ellos o por una combinación de varios.
3. Comprobar las interfaces y la compatibilidad
No todas las memorias son compatibles con todos los procesadores. Es necesario verificar las interfaces soportadas, las capacidades admitidas, la configuración de canales, las restricciones de encapsulado y los requisitos del fabricante.
También deben comprobarse los requisitos de alimentación, secuenciación, inicialización y diseño de alta velocidad.
4. Considerar consumo, coste y evolución del producto
Una memoria de mayores prestaciones puede aumentar el coste, el consumo y la complejidad. La decisión debe responder a los requisitos reales, sin sobredimensionar innecesariamente el producto.
También conviene evaluar si la arquitectura deja margen para futuras actualizaciones, modelos de mayor tamaño o nuevas funciones.
5. Validar el diseño antes de cerrar la arquitectura
Cuando la aplicación es exigente, las estimaciones deben contrastarse mediante pruebas y mediciones. El análisis del ancho de banda efectivo, la latencia y el comportamiento de la aplicación permite identificar limitaciones que no siempre resultan evidentes a partir de las especificaciones de los componentes.
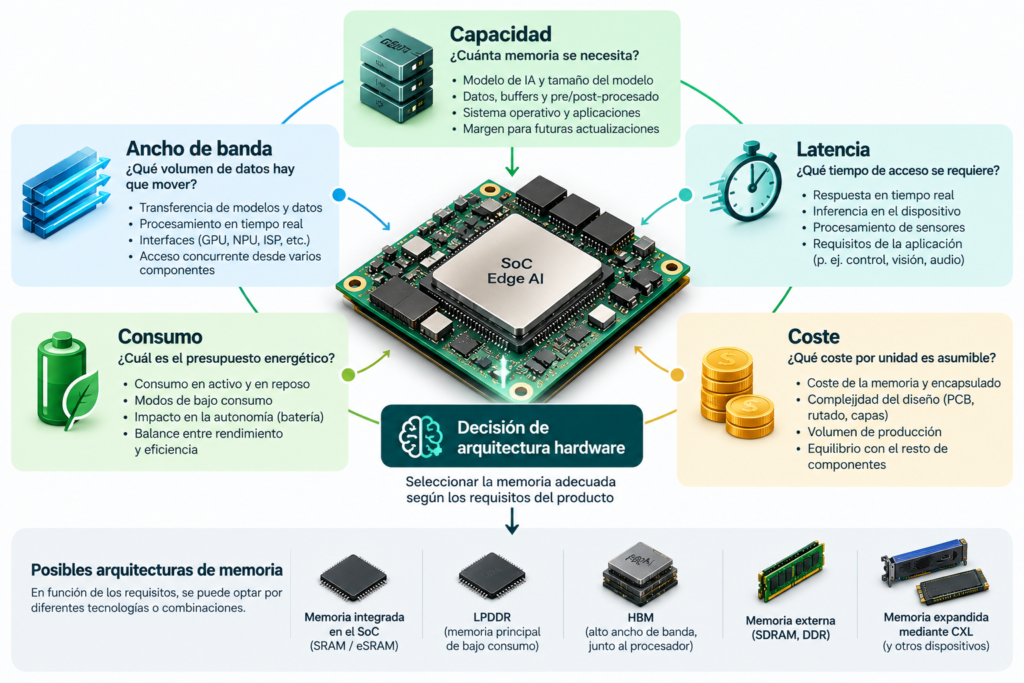
Todas estas decisiones requieren una visión conjunta del procesador, la memoria, las interfaces y las restricciones físicas del producto. Por eso, contar con un servicio especializado en diseño y desarrollo de productos electrónicos desde las primeras fases del proyecto permite definir una arquitectura coherente, anticipar posibles limitaciones y reducir el riesgo de rediseños durante el desarrollo del hardware.
Conclusión
HBM y CXL representan dos enfoques diferentes para responder a las necesidades crecientes de los sistemas de inteligencia artificial.
HBM proporciona un ancho de banda muy elevado mediante una arquitectura de memoria apilada e integrada cerca de GPU y aceleradores. CXL permite conectar recursos compatibles y construir sistemas con mayor flexibilidad para ampliar o gestionar la memoria y otros recursos de computación.
No son tecnologías equivalentes ni sustitutas directas. Pueden desempeñar funciones complementarias dentro de una arquitectura que combina diferentes niveles de memoria según las necesidades de cada carga de trabajo.
Para el diseño electrónico, la conclusión fundamental es que la memoria debe formar parte de la definición de la arquitectura desde el inicio del proyecto. Capacidad, ancho de banda, latencia, consumo, coste e integración condicionan el rendimiento y las posibilidades de evolución de un producto.
Este principio es aplicable tanto a sistemas de IA de alto rendimiento como a dispositivos embebidos y Edge AI, aunque las tecnologías utilizadas sean muy diferentes.
¿Estás diseñando un dispositivo IoT o un sistema Edge AI?
Definir correctamente la arquitectura hardware ayuda a seleccionar los componentes adecuados, evaluar los requisitos de memoria y procesamiento y reducir el riesgo de rediseños cuando el proyecto ya está avanzado.
En Kenso Circuits, empresa especializada en diseño electrónico y desarrollo de sistemas embebidos en Valencia, ayudamos a empresas a definir la arquitectura de sus productos, seleccionar componentes y desarrollar hardware adaptado a las necesidades de cada aplicación.
Si estás trabajando en un dispositivo IoT, un equipo de visión artificial o un sistema Edge AI, podemos ayudarte a evaluar los requisitos técnicos y definir una arquitectura coherente antes de iniciar el diseño de PCB.
Contacta con Kenso Circuits para estudiar las necesidades de tu proyecto.
Preguntas frecuentes sobre HBM y CXL
¿Qué es HBM?
HBM significa High Bandwidth Memory. Es una tecnología de memoria DRAM que utiliza chips apilados e interfaces muy amplias para proporcionar un ancho de banda elevado a GPU y aceleradores de alto rendimiento.
¿Qué diferencia existe entre HBM y DDR?
DDR se utiliza habitualmente como memoria principal y ofrece un equilibrio entre capacidad, coste y rendimiento. HBM prioriza el ancho de banda y requiere una integración física más compleja, por lo que se emplea especialmente en aceleradores de IA y sistemas de computación de alto rendimiento.
¿Qué es CXL?
CXL (Compute Express Link) es un estándar de interconexión que permite comunicar procesadores, aceleradores y dispositivos compatibles. Entre sus aplicaciones se encuentran la expansión de memoria y determinadas arquitecturas de asignación o compartición de recursos.
¿HBM y CXL son tecnologías competidoras?
No necesariamente. HBM es una tecnología de memoria de alto ancho de banda, mientras que CXL es una interconexión. Un sistema compatible puede utilizar HBM junto al acelerador y recursos de memoria adicionales conectados mediante CXL.
¿Qué relación tienen HBM y Edge AI?
HBM se utiliza principalmente en sistemas de alto rendimiento, pero el problema que intenta resolver también existe en Edge AI: el procesador debe acceder a los datos con suficiente rapidez. En dispositivos embebidos suelen emplearse otras tecnologías, como SRAM, PSRAM, SDRAM o DDR, en función de los requisitos.
¿Más memoria mejora siempre el rendimiento de la inteligencia artificial?
No. Una mayor capacidad permite mantener más datos disponibles, pero no garantiza una ejecución más rápida. El rendimiento también depende del ancho de banda, la latencia, la capacidad de cálculo, el software y la forma en que se transfieren los datos.
¿Qué debe tenerse en cuenta al seleccionar memoria para un dispositivo electrónico?
Hay que evaluar la capacidad requerida, el ancho de banda, la latencia, el consumo, el coste, la compatibilidad con el procesador y las restricciones de diseño. En aplicaciones exigentes, también es importante validar el comportamiento real antes de cerrar la arquitectura hardware.
¿Qué es HBF y en qué se diferencia de HBM?
Las siglas HBF deben interpretarse según el contexto técnico concreto. No conviene tratarlas como equivalentes a HBM sin identificar la tecnología, propuesta o denominación específica a la que se refiere la fuente. Antes de incluir una comparativa, es necesario disponer de una referencia técnica inequívoca.
Contacta con Kenso Circuits para analizar las necesidades técnicas de tu proyecto y definir una arquitectura hardware preparada para sus requisitos actuales y su evolución futura.