La inteligencia artificial ya no necesita ejecutarse exclusivamente en grandes servidores o en la nube. Gracias a la evolución de los microcontroladores, los procesadores embebidos y los aceleradores especializados, cada vez es más viable analizar datos y ejecutar modelos de aprendizaje automático directamente en un dispositivo electrónico.
Este enfoque, conocido como Edge AI, permite reducir la latencia, limitar el envío de información a servidores externos y desarrollar productos que pueden seguir funcionando incluso cuando la conexión a Internet no está disponible.
Sin embargo, no todos los microcontroladores ofrecen las mismas capacidades. Una aplicación que detecta anomalías a partir de las vibraciones de un motor tiene unos requisitos muy diferentes de un sistema que analiza imágenes o ejecuta varias redes neuronales simultáneamente.
En esta guía comparamos las principales arquitecturas de hardware para inteligencia artificial embebida, desde microcontroladores orientados a TinyML hasta plataformas con unidades de procesamiento neuronal (NPU) y procesadores con GPU. También veremos cómo elegir la solución adecuada según el modelo, la memoria, el consumo energético y las necesidades del producto.
Resumen: ¿qué plataforma elegir para Edge AI?
La elección depende principalmente de la complejidad del modelo, la memoria disponible, el consumo permitido y el tipo de datos que debe procesar el dispositivo.
| Plataforma o arquitectura | Punto fuerte | Aplicaciones orientativas |
|---|---|---|
| ESP32-S3 | Equilibrio entre coste, conectividad y procesamiento | Clasificación de sensores, audio y TinyML |
| Cortex-M55 / Cortex-M85 | Procesamiento DSP y extensiones vectoriales Arm Helium | Inferencia eficiente y procesamiento de señales |
| STM32N6 | Aceleración neuronal mediante NPU integrada | Visión artificial y modelos compatibles con su acelerador |
| PSoC Edge | Arquitectura orientada a aplicaciones embebidas con aceleración de aprendizaje automático según variante | Audio, sensores y aplicaciones de IA local |
| RISC-V con extensiones vectoriales | Flexibilidad arquitectónica y procesamiento vectorial | Sistemas embebidos que aprovechan implementaciones compatibles |
| NVIDIA Jetson Orin Nano | GPU y ecosistema de software para IA de mayor complejidad | Visión artificial avanzada y múltiples modelos |
Esta tabla sirve como primera orientación, no como un ranking absoluto. Las capacidades reales dependen del modelo exacto, las herramientas disponibles, la memoria, los operadores soportados y las condiciones de ejecución.
Una distinción fundamental: TinyML no es un tipo de microcontrolador, sino un enfoque para ejecutar modelos de aprendizaje automático con recursos limitados. Edge AI es un concepto más amplio que incluye microcontroladores, procesadores de aplicaciones, GPU y otras plataformas capaces de procesar datos cerca de su origen.
¿Qué necesita un microcontrolador para ejecutar inteligencia artificial?
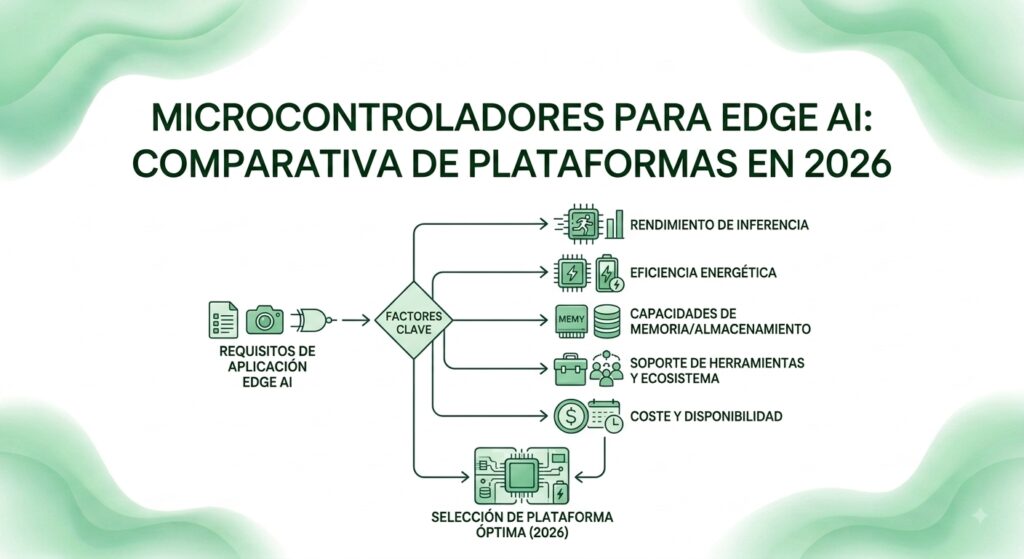
La ejecución de una red neuronal implica mucho más que disponer de una CPU rápida. Antes de seleccionar un componente, conviene analizar cinco factores.
1. Capacidad de procesamiento
Las redes neuronales realizan operaciones matemáticas repetitivas, como multiplicaciones, acumulaciones y convoluciones. Su rendimiento depende de la arquitectura del procesador y de la disponibilidad de instrucciones optimizadas para estas operaciones.
Un microcontrolador con instrucciones SIMD o extensiones vectoriales puede procesar varios valores en paralelo. Una NPU, por su parte, está diseñada específicamente para acelerar determinadas operaciones de redes neuronales.
La frecuencia de reloj, por sí sola, no permite comparar el rendimiento de dos plataformas. También deben considerarse la arquitectura, las instrucciones disponibles, el tipo de modelo y el software de inferencia.
Para profundizar en este aspecto, consulta el artículo de KensoCircuits sobre extensiones vectoriales y su papel en la IA embebida.
2. Memoria Flash y RAM
La memoria determina qué modelo puede almacenarse y ejecutarse en el dispositivo.
La memoria Flash suele alojar el firmware, los parámetros del modelo y otros recursos persistentes. La RAM se utiliza durante la inferencia para almacenar entradas, activaciones intermedias, tensores, resultados temporales y buffers.
Por tanto, un modelo de 1 MB no implica necesariamente que baste con disponer de 1 MB de RAM. El consumo de memoria de trabajo puede ser muy superior al tamaño del archivo del modelo.
También hay que valorar si la plataforma permite ampliar la memoria mediante PSRAM, SDRAM u otras interfaces externas. Estas opciones pueden aumentar la capacidad disponible, aunque añaden requisitos de diseño, consumo, latencia y coste.
Puedes ampliar este punto en nuestra guía sobre arquitectura de memoria para dispositivos IoT y Edge AI.
3. Aceleración para aprendizaje automático
Existen distintos niveles de aceleración:
- CPU convencional: ejecuta las operaciones del modelo mediante instrucciones generales.
- DSP y SIMD: aceleran operaciones matemáticas y procesamiento de señales.
- Extensiones vectoriales: permiten procesar varios elementos de datos mediante una misma instrucción.
- NPU: acelera operaciones de redes neuronales que sean compatibles con su arquitectura.
- GPU: ofrece una elevada capacidad de procesamiento paralelo, especialmente útil en modelos y aplicaciones más exigentes.
Estas tecnologías no son intercambiables. La aceleración efectiva depende de que el compilador, el runtime y el modelo puedan aprovechar el hardware disponible. Si una operación no está soportada por el acelerador, puede ejecutarse en la CPU o requerir una adaptación del modelo.
4. Consumo energético
En dispositivos alimentados por batería, no basta con medir el consumo máximo del procesador. Es necesario calcular la energía utilizada durante un ciclo completo de trabajo.
Deben incluirse la adquisición de datos, el procesamiento, la inferencia, las comunicaciones inalámbricas y los periodos de reposo. Un acelerador puede reducir el tiempo de cálculo, pero su conveniencia depende de la energía consumida por inferencia y del resto del sistema.
5. Ecosistema de desarrollo
La disponibilidad de herramientas influye directamente en el tiempo necesario para desarrollar el producto.
Es importante comprobar si existen bibliotecas optimizadas, herramientas de conversión y cuantización de modelos, soporte para los operadores necesarios, ejemplos de referencia y mecanismos para medir el rendimiento real.
Una plataforma con buenas prestaciones teóricas puede resultar poco adecuada si no permite desplegar el modelo previsto de forma fiable.
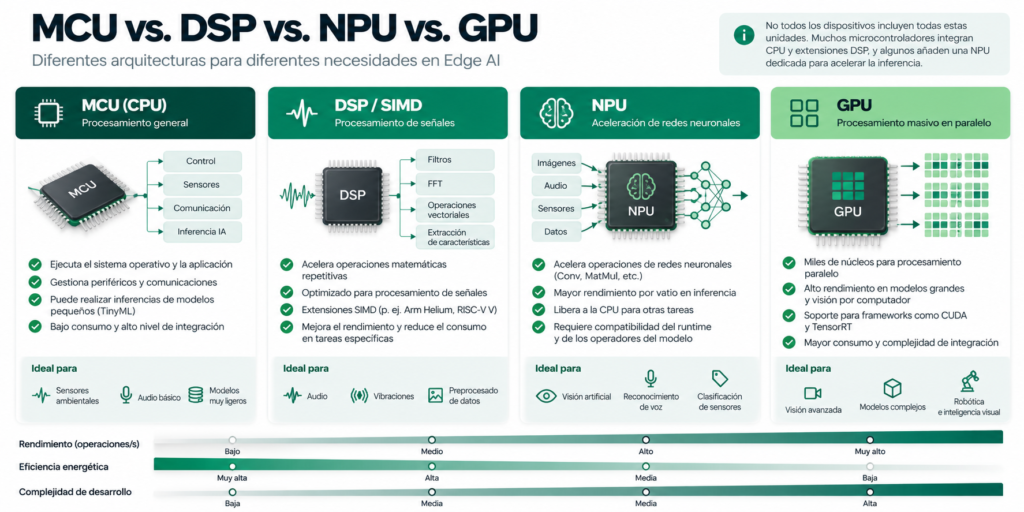
¿Qué diferencia hay entre MCU, DSP, NPU y GPU?
No todos los procesadores ejecutan las operaciones de inteligencia artificial de la misma manera. Una CPU ofrece flexibilidad para controlar el dispositivo y ejecutar tareas generales; un DSP o las extensiones SIMD aceleran determinadas operaciones matemáticas y de señal; una NPU está especializada en operaciones de redes neuronales compatibles; y una GPU permite paralelizar cargas de cálculo más exigentes.
La siguiente infografía resume sus diferencias y muestra en qué tipos de aplicaciones puede resultar más interesante cada arquitectura.
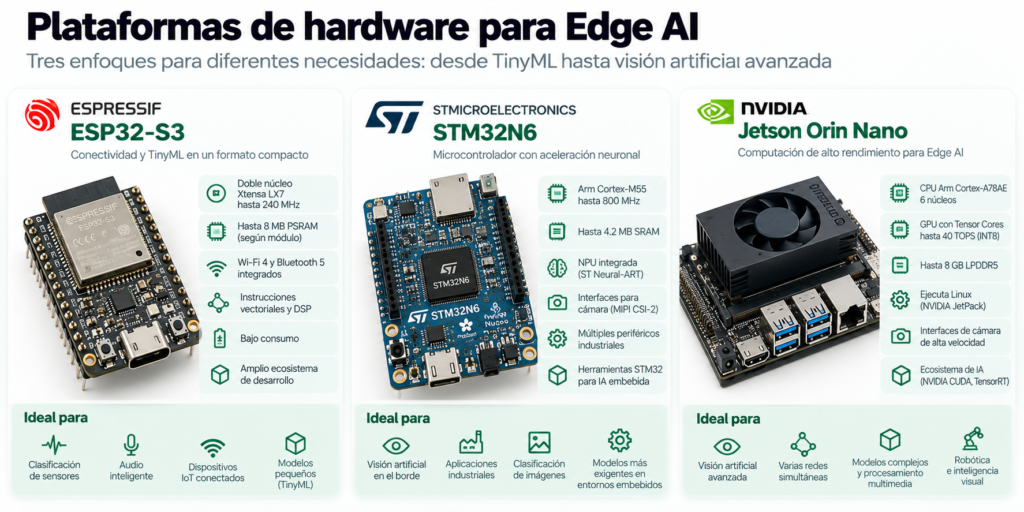
Principales plataformas para Edge AI
ESP32-S3: una opción accesible para TinyML
El ESP32-S3 de Espressif es una plataforma interesante para dispositivos conectados que necesitan ejecutar modelos relativamente pequeños sin recurrir a un procesador de aplicaciones más complejo.
Su arquitectura de doble núcleo Xtensa LX7, sus instrucciones orientadas a determinadas operaciones vectoriales y su conectividad integrada lo hacen adecuado para numerosos proyectos de sensores inteligentes, procesamiento de audio y clasificación de datos.
Entre sus aplicaciones potenciales se encuentran:
- Detección de anomalías a partir de señales de sensores.
- Reconocimiento de palabras clave y determinadas tareas de audio.
- Clasificación de patrones procedentes de acelerómetros.
- Sistemas de control que combinan reglas convencionales e inferencia local.
El ESP32-S3 no incorpora una NPU dedicada equivalente a la de plataformas diseñadas específicamente para visión artificial acelerada. Por ello, es importante elegir modelos compatibles con sus recursos y medir el tiempo de inferencia y el consumo de RAM.
Su principal ventaja es el equilibrio entre coste, conectividad y facilidad de integración en productos IoT.
ESP32-P4: procesamiento avanzado y multimedia
El ESP32-P4 amplía las posibilidades de la familia Espressif con una arquitectura de doble núcleo RISC-V y capacidades orientadas al procesamiento de alto rendimiento y multimedia.
Puede resultar interesante en productos con interfaces gráficas, procesamiento de imagen, cámaras y tareas de computación en el borde. Sin embargo, conviene distinguir entre las capacidades de procesamiento multimedia del chip y la aceleración específica de redes neuronales: no toda función de imagen equivale a disponer de una NPU.
También hay que considerar que la conectividad inalámbrica puede requerir componentes externos, según la arquitectura del producto.
La selección del ESP32-P4 debe basarse en los periféricos necesarios, los requisitos de memoria y las bibliotecas disponibles para la aplicación prevista.
Arm Cortex-M55 y Cortex-M85: DSP e instrucciones vectoriales
Los procesadores Arm Cortex-M55 y Cortex-M85 incorporan la tecnología Arm Helium, basada en la extensión vectorial MVE, que acelera determinados algoritmos de procesamiento digital de señales y aprendizaje automático.
Estas capacidades pueden mejorar el rendimiento de operaciones como convoluciones, multiplicaciones de matrices y procesamiento de señales, siempre que el software esté optimizado para aprovecharlas.
Su interés reside en combinar un entorno de microcontrolador con instrucciones diseñadas para cargas de trabajo matemáticas intensivas.
No obstante, la capacidad final de una plataforma depende también del microcontrolador concreto, su frecuencia, la memoria disponible y las bibliotecas utilizadas. No debe asumirse que todos los dispositivos basados en Cortex-M55 o Cortex-M85 incorporan una NPU independiente.
STM32N6: microcontrolador con aceleración neuronal
La familia STM32N6 de STMicroelectronics está orientada a aplicaciones que necesitan ejecutar tareas de inteligencia artificial más exigentes en un sistema embebido.
Su arquitectura incorpora un procesador Arm Cortex-M55 y una unidad de procesamiento neuronal dedicada. Esta combinación permite acelerar modelos compatibles y abre la puerta a aplicaciones de visión artificial, clasificación de imágenes y detección de objetos.
Para aprovechar estas prestaciones es necesario utilizar modelos y operadores compatibles con la cadena de herramientas de ST, además de dimensionar correctamente la memoria y los buffers.
Antes de elegir esta familia, conviene comprobar el rendimiento medido sobre el modelo objetivo, las interfaces disponibles en la referencia seleccionada y los requisitos de memoria del sistema completo.
PSoC Edge: procesamiento embebido con aceleración de aprendizaje automático
La familia PSoC Edge de Infineon está diseñada para aplicaciones que combinan procesamiento embebido, conectividad con periféricos y capacidades de aprendizaje automático.
Sus recursos concretos varían según la variante seleccionada. Por ello, es necesario comprobar qué unidades de procesamiento, aceleradores, memoria e interfaces incluye cada dispositivo, así como el soporte disponible para desplegar modelos.
Puede ser una alternativa interesante cuando se necesita integrar el procesamiento de señales y la inferencia dentro de una arquitectura embebida, especialmente en aplicaciones de audio, sensores y equipos inteligentes.
La comparación con otras familias debe hacerse sobre la referencia exacta y con el mismo modelo de prueba, no únicamente a partir de las características generales de la familia.
RISC-V y las extensiones vectoriales
RISC-V es una arquitectura de conjunto de instrucciones abierta que permite desarrollar implementaciones de procesadores con características diferentes según los objetivos de cada fabricante.
Una de las tecnologías relevantes para la IA embebida es RISC-V Vector Extension (RVV), que permite realizar operaciones vectoriales sobre múltiples elementos de datos. Su utilidad depende de que la implementación del procesador incluya las extensiones correspondientes y de que el compilador y las bibliotecas puedan aprovecharlas.
No todos los microcontroladores RISC-V incorporan RVV ni disponen de aceleración específica para redes neuronales. Por eso, es necesario distinguir entre la arquitectura base y las extensiones implementadas en cada producto.
RISC-V ofrece flexibilidad para el desarrollo de soluciones especializadas, pero la madurez del ecosistema de software y el soporte de herramientas deben formar parte de la decisión.
NVIDIA Jetson Orin Nano: cuando un microcontrolador no es suficiente
Hay aplicaciones en las que las capacidades de un microcontrolador no bastan. La ejecución de modelos de visión artificial complejos, varias redes neuronales simultáneas o algoritmos que necesitan un entorno Linux puede requerir una plataforma más potente.
NVIDIA Jetson Orin Nano es un ejemplo de plataforma de computación embebida que combina CPU y GPU con un ecosistema de software orientado a IA.
Frente a un MCU, ofrece más capacidad de cálculo y permite abordar aplicaciones de mayor complejidad, pero normalmente implica un mayor consumo energético, un coste superior y más requisitos de alimentación, refrigeración y diseño del sistema.
No debe considerarse un competidor directo de un microcontrolador de bajo consumo. Es una alternativa para proyectos con necesidades de procesamiento diferentes.
Comparativa técnica: qué evaluar antes de elegir
La siguiente tabla resume las diferencias de enfoque entre las principales plataformas. Los datos de rendimiento concretos deben verificarse para la referencia comercial y la configuración elegidas.
| Plataforma | Tipo de procesamiento | Aceleración | Punto crítico de selección |
|---|---|---|---|
| ESP32-S3 | MCU conectado | Instrucciones optimizadas y DSP | Tamaño del modelo y RAM disponible |
| ESP32-P4 | MCU de mayor capacidad y multimedia | Recursos de procesamiento específicos de la plataforma | Interfaces, memoria y soporte del modelo |
| Cortex-M55/M85 | Núcleo de microcontrolador | Arm Helium/MVE | Soporte de bibliotecas y rendimiento por aplicación |
| STM32N6 | MCU orientado a IA | NPU integrada | Compatibilidad del modelo y memoria |
| PSoC Edge | Plataforma embebida para IA | Según variante | Aceleradores y herramientas de la referencia |
| RISC-V con RVV | Depende de la implementación | Procesamiento vectorial | Disponibilidad real de RVV y soporte de software |
| Jetson Orin Nano | Plataforma MPU/GPU | GPU y ecosistema CUDA | Consumo, refrigeración y complejidad del sistema |
Para comparar de manera rigurosa, registra al menos cuatro métricas:
- Latencia de inferencia: tiempo necesario para procesar una entrada.
- Memoria máxima utilizada: RAM requerida durante la ejecución real.
- Energía por inferencia: energía consumida para completar una operación.
- Precisión del modelo: calidad de los resultados con la cuantización y optimizaciones aplicadas.
Cuando se utilicen cifras de TOPS, FPS o latencia, debe indicarse si proceden de una ficha técnica, de un benchmark del fabricante o de una prueba propia. También es necesario especificar el modelo, la precisión numérica y las condiciones de ejecución.
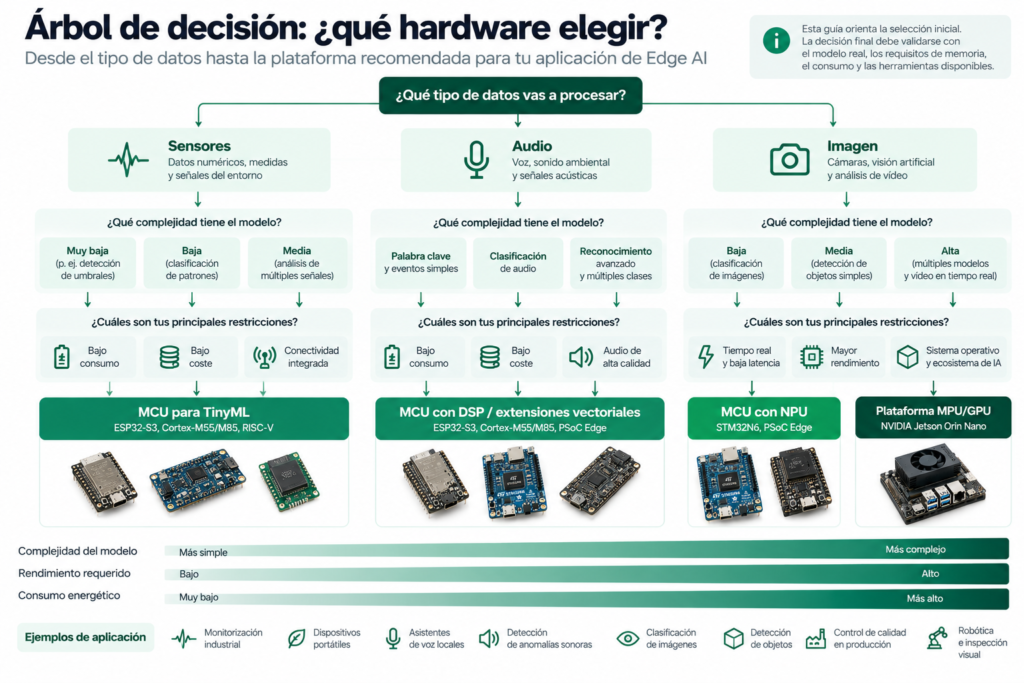
¿Qué arquitectura elegir según la aplicación?
No existe un único microcontrolador ideal para todos los proyectos de Edge AI. La decisión debe comenzar por la tarea que el dispositivo necesita resolver.
| Aplicación | Arquitectura inicial que conviene evaluar | Qué comprobar |
|---|---|---|
| Clasificación de sensores y vibraciones | MCU de bajo consumo con DSP o SIMD | Frecuencia de muestreo, RAM y latencia |
| Detección de palabras clave | MCU con soporte de audio y bibliotecas optimizadas | Memoria, consumo y calidad de la señal |
| Reconocimiento de imágenes | MCU con aceleración compatible o plataforma MPU/GPU | Resolución, memoria y rendimiento del modelo |
| Varias redes neuronales simultáneas | Plataforma con mayor capacidad de cálculo | Ancho de banda de memoria y carga combinada |
| Visión artificial con sistema operativo | Plataforma MPU/GPU | Compatibilidad del software, alimentación y refrigeración |
| Monitorización industrial con batería | MCU eficiente con inferencia local | Energía por ciclo y tiempo en reposo |
Estas recomendaciones son puntos de partida. La decisión definitiva debe validarse con el modelo real, los sensores y las condiciones ambientales del producto.
¿Cuándo elegir TinyML, Edge AI avanzado o la nube?
TinyML suele ser adecuado cuando el modelo es pequeño, las entradas están bien definidas y el dispositivo tiene restricciones importantes de energía, coste y memoria.
Edge AI avanzado resulta más apropiado cuando el producto necesita procesar imágenes de mayor resolución, ejecutar varios modelos o aprovechar aceleradores especializados.
La nube puede ser conveniente para modelos que requieren grandes recursos de cálculo, procesamiento centralizado o acceso a datos de múltiples dispositivos. A cambio, introduce dependencia de la conectividad, latencia de red y consideraciones adicionales de privacidad y coste.
Una arquitectura híbrida permite ejecutar las tareas críticas localmente y enviar a la nube únicamente los resultados o los datos que necesitan un análisis adicional.
Puedes ampliar la explicación en nuestra guía sobre Edge AI y su impacto en el diseño de hardware embebido.
Herramientas para desarrollar aplicaciones de Edge AI
La plataforma de hardware es solo una parte de la solución. También es necesario entrenar, optimizar, convertir e integrar el modelo en el firmware.
TensorFlow Lite for Microcontrollers
TensorFlow Lite for Microcontrollers está diseñado para ejecutar modelos de aprendizaje automático en microcontroladores con recursos limitados.
Su utilidad depende del conjunto de operadores soportados, de la memoria disponible y de las optimizaciones específicas de la plataforma. Antes de integrar un modelo, conviene comprobar que todas las operaciones necesarias estén disponibles o puedan implementarse de forma eficiente.
Edge Impulse
Edge Impulse proporciona herramientas para desarrollar flujos de trabajo de aprendizaje automático embebido, desde la preparación de los datos hasta la evaluación y el despliegue.
Puede resultar especialmente útil para prototipar aplicaciones basadas en señales de sensores, audio o imágenes, así como para comparar modelos y evaluar sus requisitos antes de seleccionar el hardware definitivo.
La compatibilidad y las opciones de despliegue dependen del dispositivo y de la configuración elegida.
CMSIS-NN
CMSIS-NN es una biblioteca de kernels optimizados para redes neuronales en procesadores Arm Cortex-M. Permite mejorar el rendimiento y reducir el consumo de memoria en determinadas operaciones, siempre que el modelo y la configuración sean compatibles.
No sustituye al proceso completo de entrenamiento y conversión del modelo: forma parte de la capa de ejecución optimizada sobre el hardware.
Herramientas del fabricante
Las plataformas con NPU suelen requerir herramientas específicas para convertir, cuantizar y compilar los modelos. Estas herramientas pueden imponer restricciones sobre operadores, formatos, memoria y precisión.
Por tanto, antes de seleccionar un acelerador, conviene probar el flujo completo de despliegue y no limitarse a verificar que la plataforma anuncia soporte para IA.
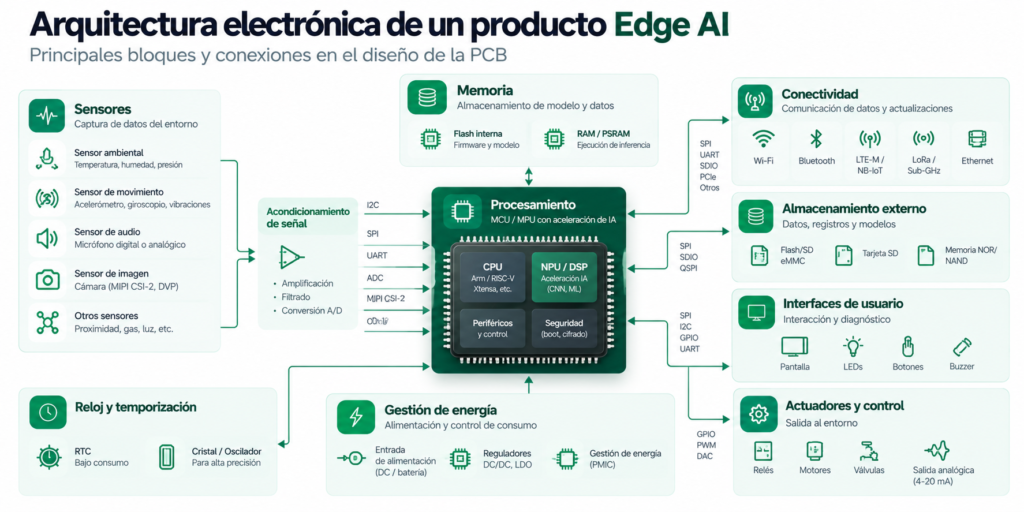
Cómo influye Edge AI en el diseño de la PCB
Una vez elegida la plataforma, el diseño electrónico debe proporcionar los recursos necesarios para ejecutar el modelo de forma fiable.
Alimentación y consumo
Los picos de corriente del procesador, la memoria y los periféricos deben contemplarse al dimensionar la alimentación. En sistemas con batería, también es necesario analizar la autonomía considerando las fases de adquisición, procesamiento, comunicación y reposo.
Memoria externa
Si el modelo o sus datos intermedios superan la capacidad de la memoria interna, puede ser necesario incorporar memoria externa. Su elección afecta al número de componentes, las líneas de alta velocidad, el consumo y el diseño de la PCB.
Sensores e interfaces
La calidad de la señal de entrada condiciona el resultado de la inferencia. En aplicaciones industriales deben evaluarse el acondicionamiento analógico, el ruido, la resolución del ADC, las frecuencias de muestreo y la sincronización de los datos.
Integridad de señal y gestión térmica
Las interfaces de memoria y las comunicaciones de alta velocidad pueden requerir especial atención a las pistas, las impedancias, el retorno de corriente y la distribución de las capas.
También es necesario comprobar la temperatura de funcionamiento bajo la carga prevista. Un sistema que funciona correctamente durante una prueba corta puede presentar limitaciones cuando ejecuta inferencias de forma continuada dentro de una carcasa cerrada.
Actualización y mantenimiento
En productos conectados, la arquitectura debe contemplar la actualización segura del firmware y, cuando corresponda, de los modelos. El almacenamiento disponible, la recuperación ante errores y la verificación de las imágenes de actualización forman parte del diseño del producto.
Para profundizar en el proceso de integración, consulta nuestra guía sobre cómo integrar un ESP32 en un producto comercial.
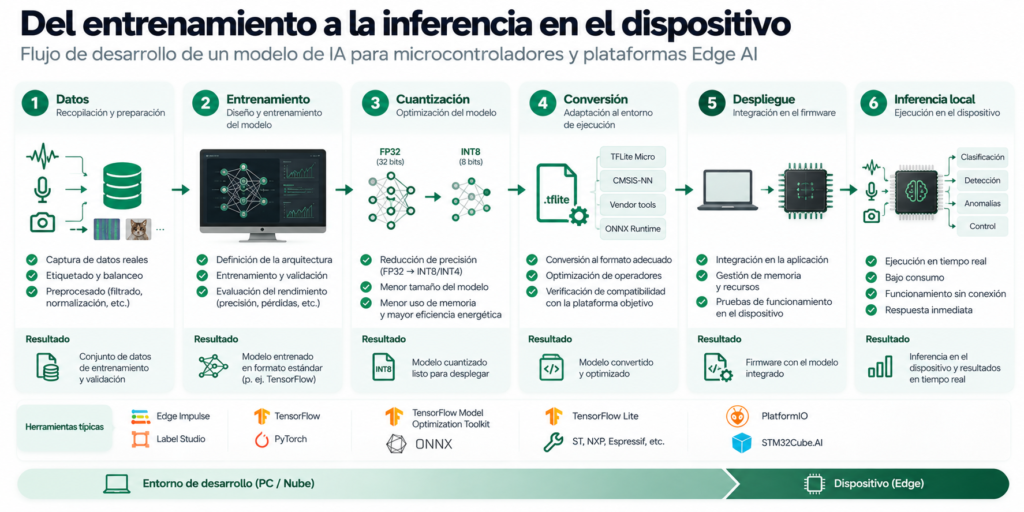
Flujo de desarrollo de un producto con Edge AI
Un proyecto de IA embebida debería comenzar con la aplicación y los datos, no con la elección de un chip concreto.
- Definir el problema. Determinar qué decisión debe tomar el dispositivo y qué entradas necesita.
- Recopilar datos representativos. Preparar muestras que reflejen las condiciones reales de funcionamiento.
- Entrenar y evaluar el modelo. Medir su precisión y comprobar su comportamiento con datos que no se hayan utilizado para entrenarlo.
- Optimizar el modelo. Evaluar cuantización, reducción del tamaño y compatibilidad con las operaciones soportadas.
- Seleccionar el hardware. Comparar memoria, latencia, consumo, coste y herramientas disponibles.
- Integrar y medir. Ejecutar el modelo en la plataforma objetivo y medir la RAM, la latencia y la energía por inferencia.
- Validar el producto. Comprobar su funcionamiento en condiciones ambientales, eléctricas y de conectividad representativas.
- Preparar la industrialización. Revisar la PCB, la disponibilidad de componentes, las actualizaciones y los procedimientos de fabricación y prueba.
Este proceso reduce el riesgo de seleccionar una plataforma que parezca suficiente sobre el papel, pero no cumpla los requisitos del producto real.
El futuro de los microcontroladores para Edge AI
La evolución del hardware embebido está acercando la inteligencia artificial a dispositivos cada vez más pequeños y eficientes. Las extensiones vectoriales, las bibliotecas optimizadas y los aceleradores neuronales permiten ejecutar modelos más exigentes sin recurrir necesariamente a una GPU o a un servidor remoto.
Al mismo tiempo, las plataformas de mayor capacidad facilitan el desarrollo de aplicaciones de visión artificial, procesamiento multimedia y sistemas híbridos que combinan inferencia local con servicios en la nube.
También está cambiando la forma de diseñar los productos. Ya no basta con comparar frecuencia de reloj, número de núcleos o cantidad de memoria. Es necesario considerar el modelo, la cadena de herramientas, el consumo energético, la disponibilidad de componentes y el ciclo de vida del dispositivo.
Para ampliar esta perspectiva, puedes consultar nuestros artículos sobre TinyML y la ejecución de IA en microcontroladores de bajo consumo y ESP-Claw y la IA agéntica en el ecosistema ESP32. Este último representa un enfoque complementario: las capacidades de un agente de IA no deben confundirse con la inferencia TinyML que puede ejecutarse directamente en un MCU.
Conclusión: elegir el hardware según el modelo y el producto
Los microcontroladores y procesadores para Edge AI ofrecen posibilidades muy diferentes. Un ESP32-S3 puede ser suficiente para determinadas aplicaciones de clasificación de sensores o audio, mientras que una plataforma con NPU puede resultar más adecuada para modelos de visión compatibles. Si el proyecto requiere varias redes neuronales o procesamiento intensivo, una plataforma MPU/GPU puede ser la opción más razonable.
La decisión debe basarse en pruebas sobre el modelo real y en requisitos medibles: precisión, latencia, memoria, energía por inferencia, coste y facilidad de industrialización.
En el diseño de un producto electrónico, la arquitectura de procesamiento, la memoria, los sensores, la alimentación y la PCB deben definirse de forma conjunta. Una selección temprana y bien fundamentada ayuda a reducir iteraciones de prototipo y a evitar cambios costosos durante la industrialización.
¿Estás desarrollando un producto electrónico con Edge AI?
En KensoCircuits ayudamos a empresas a definir arquitecturas electrónicas, seleccionar componentes, diseñar PCBs y preparar productos para su validación y fabricación.
Podemos ayudarte a evaluar la plataforma más adecuada para tu aplicación, integrar sensores y conectividad, dimensionar la memoria y diseñar el hardware necesario para ejecutar los algoritmos de forma fiable.
Solicita un estudio de viabilidad de tu producto electrónico y analiza las necesidades de tu proyecto antes de iniciar el diseño.
Preguntas frecuentes sobre microcontroladores para Edge AI
¿Qué es un microcontrolador para Edge AI?
Es un microcontrolador que se utiliza para ejecutar algoritmos de inteligencia artificial directamente en un dispositivo, normalmente cerca de los sensores que generan los datos. Puede emplear una CPU convencional, instrucciones optimizadas, extensiones vectoriales o aceleradores específicos.
¿Cuál es la diferencia entre TinyML y Edge AI?
TinyML se centra en ejecutar modelos de aprendizaje automático con recursos limitados, especialmente en microcontroladores de bajo consumo. Edge AI es un concepto más amplio que incluye desde esos dispositivos hasta plataformas con procesadores y GPU de mayor capacidad.
¿Puede un ESP32 ejecutar inteligencia artificial?
Sí. Por ejemplo, el ESP32-S3 puede ejecutar determinados modelos de TinyML y aplicaciones de procesamiento de señales, siempre que el modelo sea compatible con sus recursos de memoria y cálculo. El rendimiento depende del modelo, las optimizaciones y la aplicación.
¿Qué diferencia hay entre una CPU con extensiones vectoriales y una NPU?
Las extensiones vectoriales permiten procesar varios datos mediante una misma instrucción y pueden acelerar operaciones matemáticas generales. Una NPU está especializada en determinadas operaciones de redes neuronales. El rendimiento efectivo depende de la compatibilidad del modelo y del software.
¿Cuánta RAM necesita un modelo de inteligencia artificial?
Depende de la arquitectura y el tamaño del modelo, de las entradas, de las activaciones intermedias y de los buffers utilizados durante la inferencia. El tamaño del archivo del modelo no representa por sí solo la RAM necesaria. La forma fiable de dimensionarla es medir el consumo máximo en la plataforma objetivo.
¿Cuándo conviene utilizar una NPU?
Una NPU merece la pena cuando el modelo necesita más rendimiento del que ofrece la CPU y existe una cadena de herramientas compatible. También debe evaluarse su consumo, la memoria requerida, la latencia real y el coste adicional de la plataforma.
¿Es mejor ejecutar la IA localmente o en la nube?
La inferencia local suele ser ventajosa cuando importan la latencia, la disponibilidad sin conexión o la privacidad. La nube resulta útil para cargas de cálculo elevadas o análisis centralizados. Una arquitectura híbrida permite combinar ambos enfoques.
¿Qué debo comprobar antes de elegir un microcontrolador para Edge AI?
Como mínimo, la compatibilidad del modelo, la RAM máxima utilizada, la latencia, la energía por inferencia, las interfaces de los sensores, las herramientas de desarrollo, la disponibilidad del componente y los requisitos de fabricación del producto.
Si estás desarrollando un nuevo producto electrónico y necesitas seleccionar la plataforma más adecuada, contar con apoyo especializado puede reducir tiempos de desarrollo, minimizar riesgos y optimizar los costes de fabricación.